
Arber Sejdiji von Zenline AI im Interview über KI-Agenten, die im Händler-HQ Sortiment, Preise und Promotions vorbereiten, über Messbarkeit und Autonomie und warum er Shopping-Agenten für weniger dringlich hält.
Wenn über KI-Agenten im Handel gesprochen wird, geht es meist um Shopping-Agenten: Software, die für Kundinnen und Kunden Produkte sucht, vergleicht und womöglich kauft. Arber Sejdiji unterscheidet davon Agenten, die im Händler-HQ Entscheidungen zu Sortiment, Preis und Promotion vorbereiten, und hält diese zweite Kategorie für die dringlichere. Sejdiji ist dabei nicht nur Beobachter: Sein Zürcher Start-up Zenline AI verkauft Agenten, nach eigenen Angaben unter anderem an Otto, Futterhaus und Conrad.
Die Studienlage betrifft bislang vor allem Shopping-Agenten und zeichnet ein geteiltes Bild. Laut einer Mitteilung des EHI Retail Institute vom 10. September 2026 nutzen mehr als elf Prozent der befragten Handelsunternehmen bereits konkrete Agentic-Commerce-Anwendungen. Knapp die Hälfte plant es, wie etailment berichtete. Die Studie entstand im Auftrag des IT-Dienstleisters Softserve. Die Online-Befragung von 218 Personen aus dem Handel ist nach Angaben der Autoren nicht repräsentativ.
Kundinnen und Kunden bleiben zurückhaltender. In einer Befragung des ECC Köln vom September 2025 konnten sich 61 Prozent vorstellen, KI-Shopping-Agenten zu nutzen. Einen Kauf einschließlich Bezahlung würden ihnen aber nur 9 Prozent überlassen.
Herr Sejdiji, Sie unterscheiden zwischen Shopping-Agenten, die für Kundinnen und Kunden Produkte suchen, vergleichen und womöglich kaufen, und Agenten, die im Händler-HQ Entscheidungen über Sortiment, Preise und Promotions treffen. Worin liegt der Unterschied, und warum halten Sie die zweite Kategorie für dringlicher?
Arber Sejdiji: Ein Shopping-Agent sucht und vergleicht Produkte für Kunden. KI-Agenten im Händler-HQ bereiten die Entscheidungen vor, die davor liegen: welche Produkte ins Angebot kommen, zu welchem Preis und mit welcher Promotion.
Erkennt ein Händler relevante Produkte 3–6 Monate früher als seine Wettbewerber, macht er den Umsatz statt der anderen. Bei einem einzelnen Produkt sind das schnell Millionenbeträge. Nimmt er schwache Launches schneller heraus, bindet er weniger Working Capital. Und bessere Preisentscheidungen bringen Marge, die Händler in der aktuellen Konsumflaute dringend brauchen. Meiner Meinung nach liegt die Dringlichkeit für die Händler bei der Margenverbesserung innerhalb des Sortiments.
Shopping-Agenten werden sich meiner Einschätzung nach langsamer durchsetzen, als manche Medienartikel andeuten. Hier empfehle ich Kunden meist, die Basics aufzusetzen: eine robots.txt, die KI-Assistenten Zugriff gibt, sauber strukturierte Produktdaten und gut gepflegte Beziehungen zwischen Produkten.
Und um beide Themen zu verbinden: Ein Shopping-Agent vergleicht Sortiment und Preise eines Händlers in Sekunden und kann nur empfehlen, was der Händler vorher gelistet und kompetitiv bepreist hat.
Bei Shopping-Agenten raten Sie Ihren Kunden derzeit nur zu den Basics. Viele Händler und Dienstleister sehen das anders und investieren bereits in Agentic Commerce. Woran machen Sie Ihre Einschätzung fest, und ab welchem Signal würden Sie Ihren Kunden raten, mehr zu investieren?
Arber Sejdiji: Bei Shopping-Agenten beobachten wir genau das, was auch die aktuellen Studien zeigen: Laut ECC Köln würden nur 9 Prozent der Verbraucher einen Kauf einschließlich Bezahlung an eine KI abgeben. Das Kaufverhalten im Massenmarkt verändert sich über Jahre, eher Jahrzehnte, das hat schon der E-Commerce gezeigt. Wer hier zu früh Vollgas gibt, hat hohe Kosten bei geringem Return on Investment. Gleichzeitig bereuen viele Händler heute, den E-Commerce nicht früher ernst genommen zu haben. Unser Mantra für Kunden lautet deshalb: Basics machen. Das war es aber auch schon für 2027. Mehr investieren würde ich, sobald ein spürbarer Anteil des Traffics oder Umsatzes messbar über KI-Assistenten kommt.
Sie vergleichen das Tempo bei Shopping-Agenten mit dem des E-Commerce. In Deutschland lag der Onlineanteil am Einzelhandel 2024 laut Handelsverband HDE bei 13,4 Prozent, in den USA zuletzt laut US Census Bureau bei 17,1 Prozent. Auf welchen Markt oder welche Kategorien bezieht sich der Vergleich? Und was bedeutet das langsamere Tempo in Deutschland für Ihre Zeitachse?
Arber Sejdiji: Der Vergleich ist als Größenordnung gemeint. In Deutschland lag der Onlineanteil am Einzelhandel 2024 laut Handelsverband HDE bei 13,4 Prozent. Nach rund drei Jahrzehnten E-Commerce wird also noch weniger als jeder siebte Euro online ausgegeben. Bei Shopping-Agenten erwarte ich einen ähnlichen Verlauf, zuerst in Kategorien, in denen Kunden viel vergleichen und sich Produkte gut über Daten beschreiben lassen, etwa Elektronik. Für Deutschland heißt das: Die Zeitachse ist eher länger als in den USA. Für Händler ist das eine gute Nachricht, weil sie Zeit haben, die Grundlagen sauber zu legen. Die Entscheidungen im eigenen Haus können sie dagegen sofort verbessern, und dort wartet die Marge schon heute.
Was entscheidet ein Agent bei Ihren Kunden heute konkret, und was entscheidet weiterhin ein Mensch? Bitte an einem Beispiel: eine Listung, eine Preisänderung, eine Auslistung. Wer gibt frei?
Arber Sejdiji: Heute bereiten unsere Agenten Entscheidungen vor, und die Category-Teams entscheiden. Jede Empfehlung kommt mit Begründung, Quellen und erwartetem Effekt. Beispiel Preisänderung: Der Agent vergleicht jede Woche den Abverkauf eines Produkts mit ähnlichen Produkten der Kategorie und mit den Preisen vergleichbarer Artikel bei Wettbewerbern. Läuft ein Produkt schwächer, schlägt er früh eine Anpassung vor, innerhalb der Margenziele und Preisleitern des Händlers. Der Category Manager prüft, gibt frei und spielt die Änderung im eigenen System aus. Bei einer Auslistung zeigt der Agent vorher, wohin die Nachfrage voraussichtlich geht: zu einem Ersatzprodukt, ob Private Label oder Marke, oder zur Konkurrenz. Für einen Produkt-Launch belegt er die Sortimentslücke mit Nachfragesignalen aus dem Markt.
Sie sprechen von drei bis sechs Monaten Vorsprung und Umsätzen in Millionenhöhe pro Produkt, an anderer Stelle von 2 bis 4 Prozent mehr Marge. Wie messen Sie das: Gegen welche Vergleichsbasis, und wie trennen Sie den Effekt der Agenten von Saison, Preisniveau oder Marketing? Bitte an einem anonymisierten Beispiel.
Arber Sejdiji: Unsere Agenten geben Empfehlungen zu Preisen, zum Sortiment und zu Kundentrends, deshalb messen wir je nach Einsatz unterschiedliche Effekte. Ich nehme ein Beispiel aus dem Pricing. Wir messen mit einem A/B-Test: Ein Teil vergleichbarer Produkte läuft mit den Empfehlungen der Agenten, der andere wie bisher. Saison, Preisniveau und Marketing wirken so auf beide Gruppen gleich. Ein Beispiel ist ein mittelgroßer europäischer Möbelhändler mit rund 9.000 Artikeln. Neue Produkte, die sich schlecht verkaufen, fielen dort früher erst nach drei bis vier Monaten in den Wochenberichten auf und mussten dann mit hohen Rabatten abverkauft werden. Der Agent vergleicht den Abverkauf jedes neuen Produkts laufend mit ähnlichen Produkten derselben Kategorie und meldet Ausreißer schon nach wenigen Wochen. Meist reichte dann eine kleine Preisanpassung. Die Bruttomarge stieg um rund 2,7 Prozentpunkte, und es lag deutlich weniger langsam drehende Ware im Lager.
Beschreiben die 2,7 Prozentpunkte den Unterschied zwischen Test- und Kontrollgruppe oder einen Vorher-nachher-Vergleich? Wie lange lief der Test, und mit wie vielen Artikeln pro Gruppe? Und welche Kennzahl meinen Sie jeweils, wenn Zenline an anderer Stelle von 2 bis 4 Prozent Marge und von 3 bis 5 Prozent EBIT-Uplift spricht?
Arber Sejdiji: Die 2,7 Prozentpunkte Bruttomarge beschreiben den Unterschied zwischen Test- und Kontrollgruppe (A/B-Test). Es kommt hier darauf an, wie elastisch die Produkte sind: Bei Beauty-Produkten sind es eher 4–6 Wochen, bei Elektronik-Produkten eher 8 Wochen. 15–20 % des Sortiments werden benötigt, um die Effektivität der Maßnahmen nachweisen zu können.
Wir messen mit unseren Kunden entweder die Profitabilität des Sortiments und verbessern hier die Bruttomarge. Hier sprechen wir dann von Bruttomargen-Verbesserung in Prozentpunkten. Bei anderen Kunden wollen wir Wachstum der absoluten Marge, hier messen wir dann die Verbesserung der absoluten Marge. Je nach Industrie und Maturität des Unternehmens sehen wir in der Regel 2–4 Prozent Verbesserung in der Bruttomarge.
Wo haben Ihre Agenten danebengelegen? Was war der teuerste oder lehrreichste Fehler bei einem Kunden, und was haben Sie danach geändert?
Arber Sejdiji: Natürlich liegen auch unsere Agenten mal daneben. Teuer geworden ist das bisher nicht, weil die Agenten Empfehlungen an die Category Manager geben und nicht selbstständig handeln. Fehler bemerken also die Mitarbeitenden des Händlers, die mit dem Agenten arbeiten, und ihre Korrekturen fließen direkt zurück in den Agenten. Damit möglichst wenige Fehler überhaupt beim Team ankommen, arbeiten unsere Agenten in mehreren Stufen: Ein „Senior-Agent“ gleicht alle Empfehlungen mit der Strategie des Unternehmens ab und sortiert aus, was nicht mit hoher Sicherheit passt.
Können Sie ein konkretes Beispiel für eine falsche Empfehlung nennen? Was hat der Agent vorgeschlagen, wie wurde der Fehler bemerkt, und was wurde danach geändert?
Arber Sejdiji: Falsche Empfehlungen können zum Beispiel Produktlistungen sein, die das Team aufgrund interner Informationen, die dem Agenten noch nicht vorlagen, bereits ausgelistet hat. Daher ist es ganz wichtig, anfangs zusammen mit jemandem, der sich mit Prompt-Inhalten und dem Prompten selbst auskennt, all diese Informationen festzuhalten. Bei uns ist das der Forward Deployed Engineer, der das zusammen mit den Retailern aufsetzt.
Ein Agent entscheidet nur so gut wie die Daten, auf die er zugreift. Laut EHI bewerten nur 39,2 Prozent der befragten Händler ihre Datenbasis als eher gut bis sehr gut. Wie weit kommt ein Agent mit den Daten, die ein typischer Händler heute hat, und wie viel Vorarbeit ist nötig, bevor er brauchbare Empfehlungen liefert?
Arber Sejdiji: Sehr weit, und zwar ohne jegliche Vorarbeit des Händlers. Wir starten mit öffentlichen Daten: Die Agenten lesen das Sortiment eines Händlers von seiner Website und vergleichen es mit dem Markt. Erste Erkenntnisse und auch Empfehlungen gibt es also bereits ohne jeglichen Datentransfer.
Danach kommen interne Daten dazu, also Abverkauf, Marge, Stammdaten und Bestand, später etwa Loyalty-, Traffic- und Promotion-Daten. Je mehr Daten, desto besser die Empfehlungen. Dafür reichen wöchentliche Uploads, eine IT-Einbindung oder ERP-Integration ist nicht nötig.
Die Datenqualität ist dabei die erste Aufgabe für unsere Agenten: Sie prüfen Attribute gegen Titel, Beschreibungen und Produktbilder, ergänzen fehlende Werte aus technischen Datenblättern und Herstellerseiten und führen Dubletten zusammen.
Die Vorarbeit bei uns ist vor allem, die Logik des Händlers zu verstehen: Wie definiert er Ersatzprodukte, welche Rolle hat eine Kategorie, welche Margenregeln gelten und wie sieht die Sortimentsstrategie im Unternehmen aus? Das bauen wir gemeinsam mit dem Team im Piloten auf.
Als langfristiges Ziel beschreibt Zenline eine „autonome Organisation“, in der ein „Schwarm an Agenten“ fast alle kommerziellen Entscheidungen zu Produkten, Preisen, Promotion und Platzierung trifft. Wie weit ist das von der heutigen Praxis entfernt? Und wer trägt die Verantwortung, wenn so ein System einen Bestseller auslistet oder eine Kategorie falsch bepreist?
Arber Sejdiji: Große Händler wie Amazon, Temu und Shein sind schon sehr nah an der autonomen Organisation. Im deutschen Handel ist der Weg noch ein ganzes Stück weg davon. Unsere optimistische Einschätzung sind fünf bis sieben Jahre. Genau diesen Weg wollen wir für den deutschen Handel aber zugänglich machen, in Stufen:
Heute bereiten Agenten Entscheidungen vor, und Menschen geben frei. Zuerst laufen Aufgaben automatisch, bei denen Fehler günstig und leicht zu korrigieren sind, etwa Produktdaten. Danach folgen Entscheidungen mit klaren Leitplanken, zum Beispiel Preisanpassungen innerhalb fester Margen- und Preisgrenzen. Bei weitreichenden Entscheidungen wie der Auslistung eines Produkts bleibt die Freigabe beim Menschen, solange das Unternehmen es so will. Unsere Aufgabe ist, dass jede Empfehlung nachvollziehbar ist: mit Begründung, Quellen und erwartetem Effekt. Ein System, dessen Entscheidungen niemand prüfen kann, würde heute kein Category-Team einsetzen.
Und wer haftet bei einer Fehlentscheidung, wenn Agenten künftig ohne Freigabe handeln: der Händler, Zenline oder beide, vertraglich geteilt?
Arber Sejdiji: Die Agenten geben Empfehlungen, die Entscheidungsgewalt bleibt beim Team, wie sonst auch.
Was wird aus dem Category Manager, wenn Agenten Sortiment und Preise steuern? Wird die Rolle kleiner, anders oder überflüssig?
Arber Sejdiji: Wie hat sich der Beruf eines Wall-Street-Bankers verändert, seit Maschinen die Entscheidungen treffen? Es werden mehr Entscheidungen in viel kürzeren Abständen getroffen. Die Menschen dahinter sind jetzt mehr für die Strategie verantwortlich, dafür, den Markt zu verstehen und das Modell zu verbessern. Ähnliches sehen wir auch im Handel. Entscheidungen wie Preisanpassungen, Listungen oder Promotions werden häufiger. Die Aufgabe der Category Manager, die vorher zwei Wochen lang Planogramme angepasst haben, wird in Zukunft viel strategischer sein: die Kunden noch besser zu verstehen und Kundenbedürfnisse noch gezielter mit dem eigenen Sortiment zu bedienen.
Ein Anbieter wie Zenline arbeitet mit mehreren Händlern, die teils in denselben Kategorien konkurrieren. Kartellbehörden, darunter das Bundeskartellamt, beschäftigen sich seit Jahren mit der Frage, ob Preisalgorithmen zu einer Angleichung von Preisen führen können. Wie stellen Sie sicher, dass die Preisentscheidungen Ihrer Kunden unabhängig voneinander bleiben? Und werden Daten oder Modelle kundenübergreifend genutzt?
Arber Sejdiji: Nein, werden sie nicht. Die Frage bekommen wir natürlich oft, besonders beim Pricing. Daten und Modelle werden nicht kundenübergreifend genutzt. Jeder Kunde arbeitet bei uns in einer komplett getrennten Umgebung. Kundendaten, Agenten und jeglicher Input bleiben beim jeweiligen Kunden, und zwischen den Agenten verschiedener Kunden gibt es weder Learnings noch Interaktionen. Auch intern haben wir Prozesse, die bestimmen, welche Mitarbeiter welche Daten von welchem Kunden einsehen dürfen. Wir sind nach ISO 27001 zertifiziert, und die Datenbanken stehen in Europa.
Wichtig ist außerdem: Wir trainieren keine eigenen Modelle. Wir bringen bestehenden Modellen relevante Retail-Workflows bei, ohne sie auf Händlerdaten zu trainieren. Händler teilen mit uns ihre sensibelsten Zahlen. Könnten sie sich nicht darauf verlassen, dass kein Wettbewerber davon profitiert, hätten wir wohl keinen einzigen Kunden.
Sie sagen, Daten und Modelle bleiben getrennt. Nutzen konkurrierende Kunden dieselben Basismodelle und dieselben Pricing-Workflows? Und wie verhindern Sie, dass gleiche Logik zu gleichgerichteten Preisen führt?
Arber Sejdiji: Daten und Modelle bleiben getrennt: Das können Sie sich wie bei Mitarbeitern auch vorstellen. Bei großen Consulting-Firmen herrscht ein striktes Austauschverbot zwischen Consultants, die auf konkurrierenden Kunden arbeiten. Das Gleiche muss natürlich für KI-Agenten gelten, sonst würde niemand seine Daten rausgeben. Die Begriffe dafür sind Chinese Wall oder Mandantentrennung. Jeder Händler hat entsprechend bei uns seine eigene Kundengruppe, eigenes Kundenverhalten, eigenes Sortiment und somit natürlich eine eigene Sortiments- und Pricing-Strategie. Entsprechend ist auch jeder Pricing-Workflow vollkommen unterschiedlich.
Anthropic hat Anfang September eine Vorlage für Commerce-Agenten veröffentlicht. Sie enthält neben einem Shopping-Agenten auch einen Merchant-Agenten für Bestand, Preise und Marketing. Wird die Händler-Agentik gerade zur Standardfunktion großer KI-Anbieter, und was bleibt dann für Spezialisten?
Arber Sejdiji: Das eine ist, kundenspezifisches Wissen in die Modelle hineinzubringen. Dafür muss man ein sehr, sehr tiefes Business-Verständnis haben, unterschiedliche Datenquellen zusammenbringen und verstehen, was sie bedeuten. Es ist unfassbar viel Arbeit, einen Agenten enterprise-ready zu machen, damit er nicht selbstbewusst eine unfundierte Antwort gibt.
Das Zweite ist: Es gibt ganz spezifische Softwareanwendungen, wie zum Beispiel Planogramme, Pricing-Management oder Promotion-Planning, in denen Menschen noch jede Woche Stunden verbringen. ChatGPT oder Claude, also die großen Modellhersteller, werden nicht in diesen Software-Stack, der 30 Jahre alt ist, hineingehen, um ihn zu verbessern.
Wie bewerten Sie konkret die Anthropic-Vorlage, deren Merchant-Agent Preise und Promotions empfiehlt? Und wie sehen Sie etablierte Anbieter von Planungssoftware, die selbst Agenten in ihre Produkte einbauen?
Arber Sejdiji: Der Anthropic-Agent ist perfekt, wenn man alle Daten super strukturiert und einfach verfügbar für den Agenten parat hat. Insbesondere wenn man sehr fortgeschritten in der IT ist, selbst gute Scraper hat, Wettbewerber-Daten hat, Marktdaten hat, Social-Media-Daten hat etc., dann ist es natürlich ein hervorragendes Tool. In der Realität haben unsere Kunden diese Daten nicht einfach verfügbar und es ist sehr komplex, die Daten gut zur Verfügung zu stellen. Für kleine Online-Händler also geeignet. Für größere Händler braucht es viel Vorarbeit und bestenfalls natürlich noch viel Marktkontext statt nur internes Agieren im Sortiment.
Sie verweisen auf die Konsumflaute, in der Händler dringend Marge brauchen. In schwachen Jahren kürzen Händler aber auch IT-Budgets. Was sollte ein mittelständischer Händler mit einigen tausend Artikeln und ohne eigenes Data-Science-Team in den nächsten zwölf Monaten tun, unabhängig davon, mit welchem Anbieter er arbeitet? Und was kostet der Einstieg ungefähr?
Arber Sejdiji: Versuchen Sie nicht, eigene Workflows mit Claude zu bauen. Die Komplexität, die damit einhergeht, wird ständig unterschätzt. Lassen Sie sich einen Acht-Wochen-Plan zeigen, und messen Sie ihn an Ihren eigenen drei Kriterien für einen erfolgreichen Piloten, zum Beispiel Auslistungen oder Margenverbesserung durch Pricing. Danach entscheiden Sie, ob das ausgerollt werden soll.
Was kann ein Händler unabhängig von einem Dienstleister selbst vorbereiten? Und welche Kostenspanne gilt ungefähr für einen Piloten?
Arber Sejdiji: Der Händler muss nichts vorbereiten, wir können mit öffentlichen Online-Shop-Daten starten.
Welche Ihrer Thesen halten Sie in einem Jahr am ehesten für überholt?
Arber Sejdiji: Am ehesten die These, dass jede Empfehlung von einem Menschen freigegeben werden muss. Heute ist das richtig, weil Vertrauen erst wachsen muss. Die Modelle werden aber gerade so schnell besser, dass die Empfehlungen bald zuverlässig genug sein werden, um viele davon ohne Freigabe umzusetzen. Ich könnte mir vorstellen, dass in einem Jahr erste Preisanpassungen innerhalb fester Leitplanken automatisch laufen. Die Category Manager legen dann die Leitplanken fest und kümmern sich vor allem um die großen Fragen wie Sortimentsstrategie, Eigenmarken und Lieferanten.
Über den Interviewten
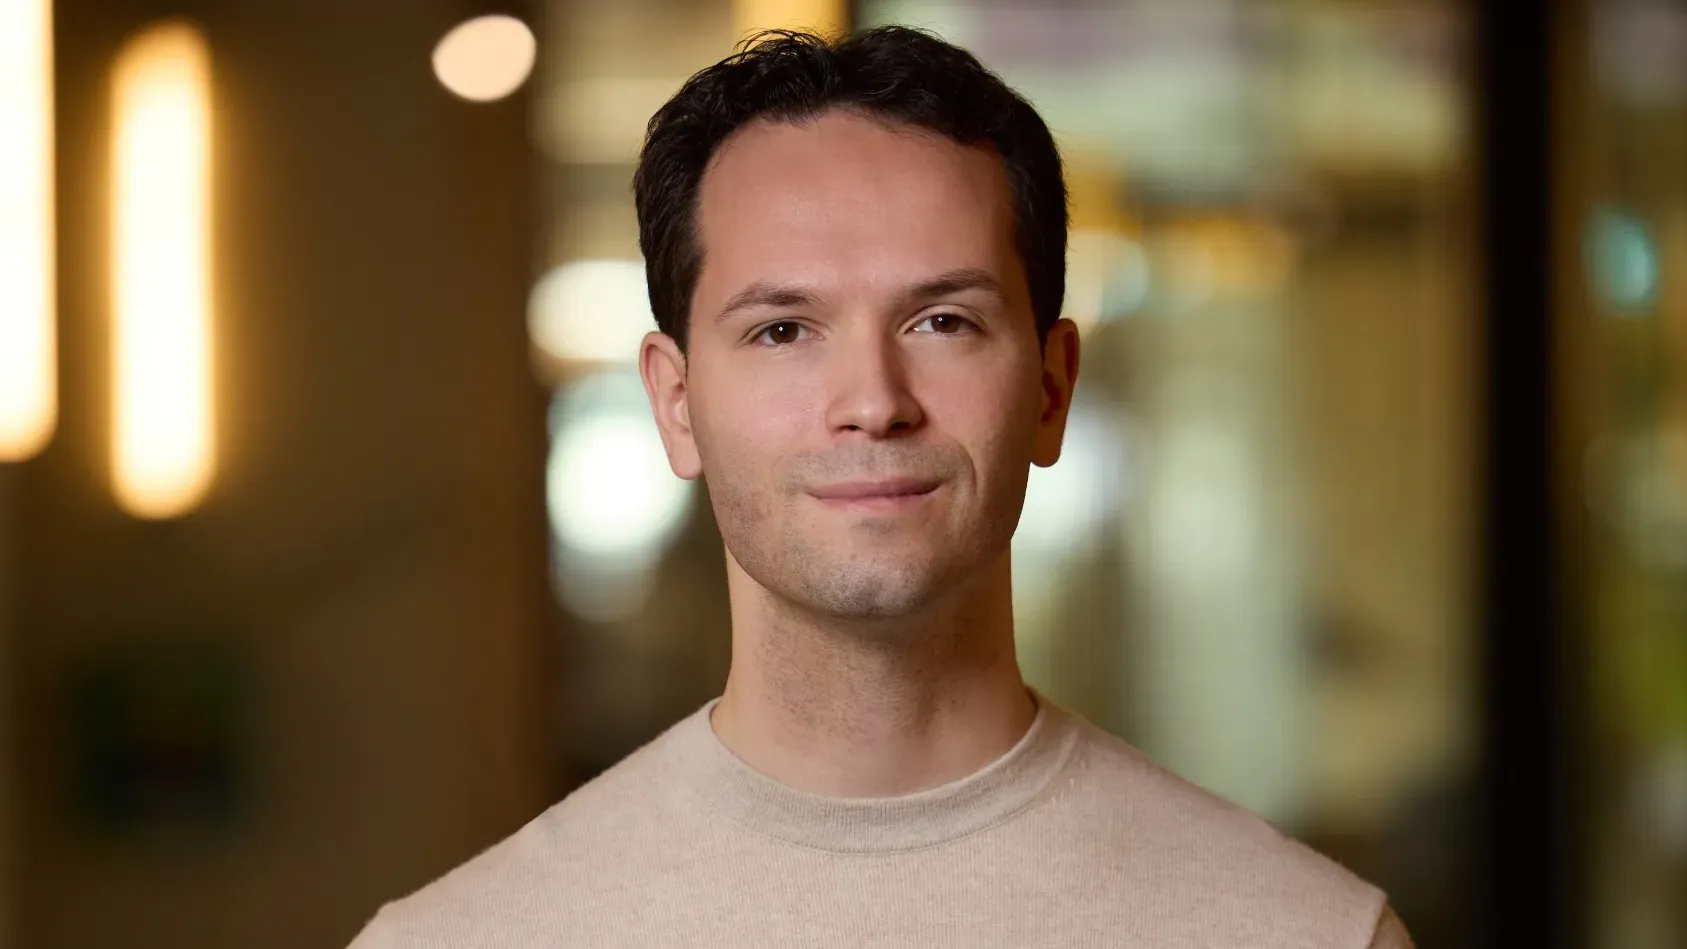
Arber Sejdiji ist CEO und Founder von Zenline AI. Das Zürcher Start-up entwickelt KI-Agenten, die Händlern Entscheidungen zu Sortiment, Preis und Promotion vorbereiten. Zu den Kunden zählen nach Unternehmensangaben Otto, Futterhaus und Conrad.